

Für Schnellleser: Google greift mit Gemini 4 Argon die Spitzenmodelle von OpenAI und Anthropic an. In mehreren Benchmarks liegt das neue Modell vor GPT-6 Astra und Claude Opus 5.5, in anderen Tests bleibt die Konkurrenz stärker. Besonders interessant ist die Verbindung mit Google Antigravity: Damit kann Gemini nicht nur Quellcode vorschlagen, sondern direkt an Softwareprojekten arbeiten. Für umfangreiche Webseiten ist das eine spannende Alternative. Gerade bei großen Spielen und über Monate gewachsenen Programmen sollten Codex und Claude Code allerdings nicht vorschnell abgeschrieben werden. Auch die richtige Zusammenarbeit von ChatGPT und Codex, die Steuerung laufender Aufgaben und der sparsame Umgang mit Tests und Kontingenten spielen bei größeren Projekten eine wichtige Rolle.
Google möchte im KI-Wettbewerb nicht nur mitspielen. Mit Gemini 4 Argon will der Konzern zeigen, dass seine Modelle inzwischen in einer Liga mit den stärksten Systemen von OpenAI und Anthropic arbeiten – und teilweise sogar besser abschneiden.
Die Zahlen, die Google dafür veröffentlicht hat, sind durchaus beeindruckend. Aber wer sich die Tabellen genauer anschaut, entdeckt auch etwas anderes: Gemini gewinnt eben nicht jeden Vergleich. Mal liegt GPT-6 Astra vorne, mal Claude Opus 5.5. Und manchmal entscheidet weniger das KI-Modell als vielmehr die Software, mit der es arbeitet.
Das eigentlich Interessante an Gemini 4 Argon ist deshalb nicht die Platzierung in einzelnen Rankings. Entscheidend ist vielmehr, ob sich damit in der Praxis bessere Webseiten, umfangreichere Anwendungen oder sogar komplette Spiele entwickeln lassen.
Was ist Gemini 4 Argon überhaupt?
Gemini 4 Argon ist Googles neues Spitzenmodell für Aufgaben, bei denen eine KI nicht nach wenigen Sekunden fertig sein soll. Im Mittelpunkt stehen längere Denkprozesse, komplexe Softwareentwicklung, Forschung, große Dokumentenbestände und Cybersicherheit.
Google hat Argon am 30. September 2026 zunächst für einen begrenzten Kreis vertrauenswürdiger Sicherheitspartner vorgestellt. Seit dem 13. Oktober 2026 ist das Modell breiter verfügbar – unter anderem in der Gemini-App für berechtigte Google-AI-Pro- und Ultra-Abonnenten, über kostenpflichtige API-Zugänge und in Googles Entwicklungsumgebung Antigravity.
Die Ankündigung lässt sich im englischen Google-Blog nachlesen. Außerdem gibt es mittlerweile einen ausführlichen deutschen Beitrag von Google, in dem weitere Anwendungen und die breitere Veröffentlichung beschrieben werden.
Ein technischer Punkt sticht heraus: Google nennt für die Gemini API ein gemeinsames Input-Output-Limit von einer Million Tokens. Vereinfacht gesagt kann das Modell damit sehr große Mengen an Informationen und erzeugtem Inhalt in einem langen Arbeitsablauf verarbeiten. Das bedeutet allerdings nicht, dass eine gewöhnliche Anfrage automatisch eine Million Tokens als Antwort liefert oder dass ein riesiges Softwareprojekt plötzlich vollständig und fehlerfrei verstanden wird.
Google zeigt beeindruckende Benchmarks – aber was bedeuten sie?
Google vergleicht Gemini 4 Argon unter anderem mit GPT-6 Astra, Claude Opus 5.5 und Claude Fable 5.1. Dabei geht es nicht nur um klassische Fragen und Antworten, sondern um echte Entwicklungsaufgaben, die Bedienung von Werkzeugen, umfangreiche Recherchen und Sicherheitsprüfungen.
Die folgende Grafik wurde für Webstratege.de auf Basis der offiziellen Modellkarte von Google DeepMind neu erstellt. Sie zeigt fünf ausgewählte Bereiche. Das Interessante daran: Die Führung wechselt je nach Aufgabe.

DeepSWE v1.1: Hier erreicht Gemini 4 Argon 77,9 %, GPT-6 Astra kommt auf 74,1 % und Claude Opus 5.5 auf 74,2 %. Dieser Test soll zeigen, wie gut ein Modell längere, mehrstufige Softwareentwicklungsaufgaben lösen kann.
FrontierSWE v2: Ganz anders sieht es hier aus. GPT-6 Astra liegt mit 65,5 % vorne, Claude Opus 5.5 kommt auf 62,3 % und Gemini 4 Argon auf 55,0 %. Ein deutliches Beispiel dafür, dass ein gutes Ergebnis beim Programmieren nicht automatisch einen Sieg in allen Coding-Tests bedeutet.
Vibe Code Bench: Gemini erreicht 91,9 %, GPT-6 Astra 89,6 % und Claude Opus 5.5 90,3 %. Hier geht es stärker um die Umsetzung von Programmieranforderungen aus natürlichsprachigen Vorgaben.
Terminal-bench 4.0: Claude Opus 5.5 erreicht 66,4 % und liegt damit vor GPT-6 Astra mit 58,2 % und Gemini 4 Argon mit 57,4 %. Gerade bei Aufgaben, bei denen ein Agent Werkzeuge und das Terminal verwenden muss, ist das durchaus relevant.
Vals Index: Dieser Test soll komplexe Wissensarbeit aus verschiedenen Wirtschaftsbereichen abbilden. Google liegt mit 68,9 % vor Claude Opus 5.5 mit 67,0 % und GPT-6 Astra mit 63,1 %.
Die Ergebnisse zeigen deutlich: Ein einziges Ranking reicht nicht aus, um die beste KI für jedes Projekt zu bestimmen.
Hinzu kommt ein Punkt, den man in Vergleichstabellen leicht übersieht. Googles veröffentlichte Benchmark-Methodik erläutert, dass Ergebnisse je nach Test aus eigenen Messungen, offiziellen Bestenlisten oder Anbieterangaben stammen. Auch die verwendeten Denkstufen und Agenten-Umgebungen spielen eine Rolle. Prozentwerte aus verschiedenen Tests lassen sich deshalb nicht einfach zusammenrechnen.
Bei der Sicherheit sieht die Rangliste spektakulärer aus, als sie tatsächlich ist
Besonders aufschlussreich ist die Grafik zum CWE-bench v1. Hier wird geprüft, wie erfolgreich KI-Systeme Sicherheitslücken in Software beheben.
In der veröffentlichten Darstellung steht Grok 4.7 ganz vorne, danach Gemini 4 Argon und GPT-6 Astra. Das klingt erst einmal nach einer klaren Reihenfolge. Schaut man allerdings auf die Prozentwerte, stellt man fest: Alle drei erreichen 68 %. Claude Opus 5.5 liegt mit 67 % nur einen Prozentpunkt dahinter.
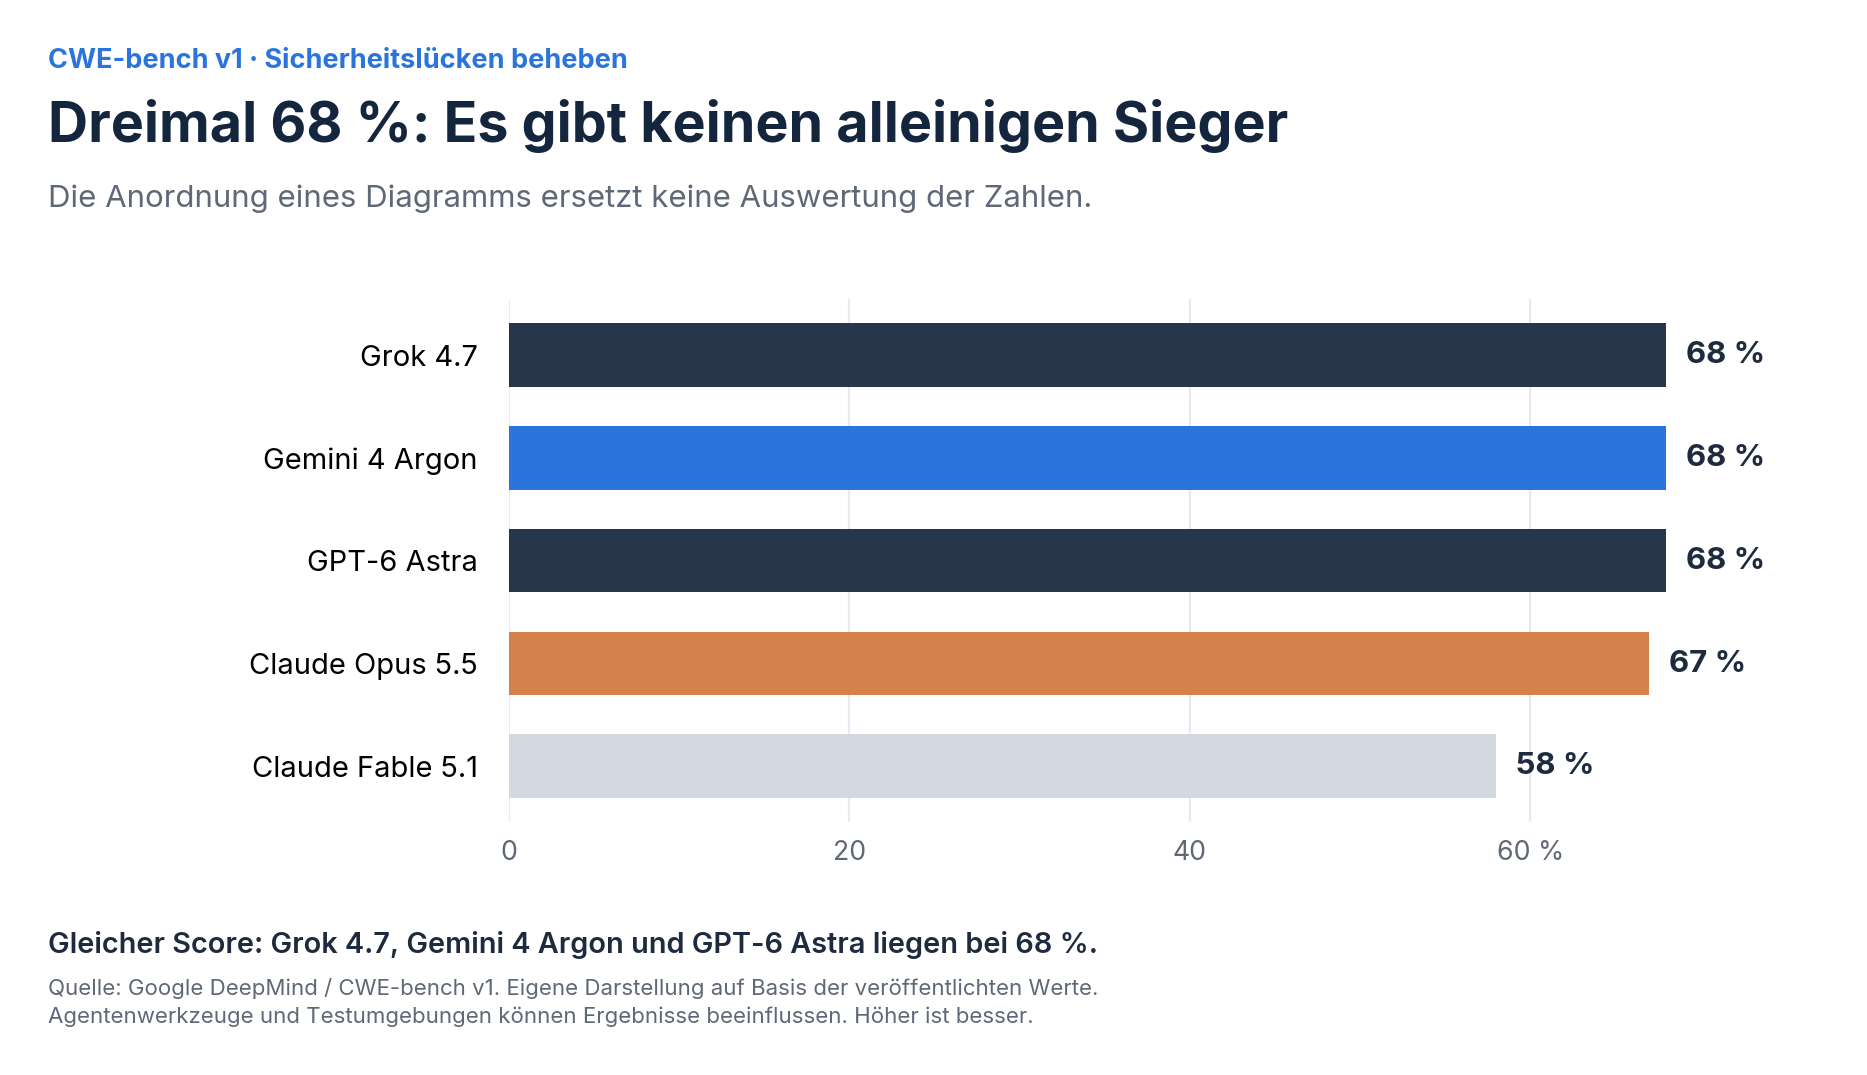
Man sollte aus der Reihenfolge der Balken also keinen eindeutigen ersten, zweiten und dritten Platz machen. 68 % bleiben 68 %, egal an welcher Position ein Anbieter sein eigenes Modell in der Grafik aufführt.
Google hat darüber hinaus interne Sicherheitsvergleiche veröffentlicht. Bei der Erkennung realer Schwachstellen erreicht Argon laut diesen Tests 85,8 %, das ältere Gemini 3.8 Flash Cyber dagegen 71,0 %. Beim internen Wiz-Penetrationstest sind es 70,9 % gegenüber 58,2 %. Das ist ein deutlicher Fortschritt innerhalb der Gemini-Familie. Allerdings handelt es sich um interne Bewertungen und nicht um einen direkten Beleg, dass Argon bei diesen beiden Aufgaben automatisch besser ist als Codex oder Claude.
Beim Gray Swan IPI, der Widerstandsfähigkeit gegen eingeschleuste Anweisungen testet, nennt Google für Argon eine erfolgreiche Angriffsquote von nur 0,7 % bei bis zu 15 adaptiven Versuchen. Hier gilt ausnahmsweise: Weniger ist besser. Auch das ist ein starkes Ergebnis – aber selbstverständlich keine Garantie, dass eine KI gegen jeden Angriff abgesichert ist.
Gemini, ChatGPT, Codex und Claude Code: Hier wird häufig etwas verwechselt
Bevor man die Systeme gegeneinander antreten lässt, sollte man unterscheiden, was genau verglichen wird.
Gemini 4 Argon, GPT-6 Astra und Claude Opus 5.5 sind KI-Modelle. ChatGPT und die Gemini-App sind Anwendungen, mit denen man solche Modelle nutzen kann. Codex, Claude Code und Google Antigravity gehen noch einen entscheidenden Schritt weiter: Es handelt sich um Programmierwerkzeuge beziehungsweise agentische Entwicklungsumgebungen, die mit Quellcodedateien, Verzeichnissen und Werkzeugen arbeiten können.
Dieser Unterschied ist wichtiger, als es zunächst klingt.
Wer eine komplexe Webseite erstellen möchte, kann einer KI mit hoher beziehungsweise sehr hoher Denkintensität heute sehr genaue Vorgaben machen. Sie kann HTML, CSS, JavaScript und teilweise ganze Webanwendungen erstellen, Designfehler erkennen, Funktionen ergänzen und bestehende Strukturen verbessern. Dafür ist nicht bei jeder Aufgabe zwingend ein spezialisierter Coding-Agent erforderlich.
Bei einem größeren Projekt sieht die Sache anders aus. Dort muss die KI unter Umständen Hunderte Dateien verstehen, eine Änderung an der richtigen Stelle vornehmen, Tests ausführen, Fehlermeldungen interpretieren und anschließend kontrollieren, ob durch die Reparatur nicht an anderer Stelle etwas kaputtgegangen ist.
Genau darin liegt die Stärke von Werkzeugen wie Codex und Claude Code. Sie können – abhängig von Zugriff, Konfiguration und Berechtigungen – direkt mit dem Projekt arbeiten, Änderungen ausführen und ihre Ergebnisse testen. Wer nur Code im Chatfenster erhält, muss diese Schritte dagegen häufig selbst übernehmen.
ChatGPT und Codex: Mit „Sehr hoch“ planen und anschließend im Projekt umsetzen
Ein besonders nützlicher Arbeitsablauf besteht darin, ChatGPT und Codex bewusst unterschiedliche Aufgaben zu geben. In ChatGPT lässt sich – abhängig vom verfügbaren Modell und Tarif – eine hohe oder sehr hohe Denkstufe einsetzen, um zunächst die Anforderungen an eine Webseite, Software oder ein Spiel sauber zu formulieren. Daraus entsteht ein präziser Arbeitsauftrag mit klaren Zielen, betroffenen Systemen und Grenzen für Änderungen.
Dieser Prompt kann anschließend in Codex übernommen werden. Dort kann beispielsweise GPT-6 Astra mit der Denkstufe „Sehr hoch“, soweit diese Einstellung verfügbar ist, die tatsächlichen Projektdateien untersuchen, gezielt Änderungen vornehmen und das Ergebnis testen. Die Kombination ist vor allem bei komplexen Vorhaben sinnvoll: ChatGPT unterstützt die Planung und die Ausarbeitung des Arbeitsauftrags, während Codex direkt mit dem Code und der Entwicklungsumgebung arbeitet.
Umgekehrt muss nicht jede kleine Änderung vorher ausführlich in ChatGPT vorbereitet werden. Wenn Codex bereits am passenden Projekt arbeitet, reichen häufig wenige eindeutige Sätze. Entscheidend ist, dass die Anweisung nicht nur das gewünschte Ergebnis nennt, sondern auch festlegt, welche bestehenden Funktionen erhalten bleiben und wie umfangreich die anschließende Prüfung ausfallen soll.
„Steuern“ oder Warteschlange: Codex noch während einer Aufgabe korrigieren
Gerade bei längeren Codex-Läufen kann eine neue Idee oder Korrektur auftauchen, während der Agent noch arbeitet. Dafür gibt es zwei unterschiedliche Vorgehensweisen: Bei „Steuern“ (Steer) soll eine ergänzende Nachricht in die bereits laufende Bearbeitung einfließen. Bei der Warteschlange (Queue) wird die Nachricht dagegen erst nach dem aktuellen Arbeitsschritt als weitere Anweisung verarbeitet. OpenAI beschreibt diesen Unterschied auch in einem Beitrag zur Remote-Nutzung von Codex.
Das ist mehr als eine kleine Bedienungsfrage. Stellt sich während der Bearbeitung heraus, dass eine bestimmte Datei unangetastet bleiben muss oder ein anderer Lösungsweg besser ist, kann eine rechtzeitige Steuerungsanweisung unnötige Umbauten verhindern. Wird dieselbe Information erst nach Abschluss der aktuellen Aufgabe verarbeitet, sind möglicherweise bereits zusätzliche Änderungen, Tests und erneute Kontrollen erforderlich. Das kann Zeit und Nutzungskontingent kosten.
Wichtig: Auch eine sofort gesendete Steuerungsanweisung macht bereits ausgeführte Änderungen nicht automatisch rückgängig. Deshalb lohnt sich nach einer Kurskorrektur eine kurze Kontrolle der tatsächlich veränderten Dateien. Neue, unabhängige Aufgaben gehören dagegen eher in die Warteschlange, damit eine laufende Reparatur nicht unnötig durcheinandergerät.
Mit Google Antigravity greift Gemini jetzt auch Codex und Claude Code direkt an
Allerdings wäre es inzwischen falsch zu behaupten, nur Codex und Claude Code könnten das.
Google hat mit Antigravity eine eigene Entwicklungsumgebung, in der Gemini 4 Argon ebenfalls mehrstufige Programmieraufgaben bearbeiten kann. Dort geht es nicht nur darum, Quellcode zu schreiben. Agenten können im Projekt arbeiten, Fehler untersuchen, Werkzeuge nutzen und Änderungen in mehreren Durchläufen weiterentwickeln.
Google berichtet beispielsweise davon, dass Argon intern an großen Chromium-Codebereichen gearbeitet, Programme optimiert und umfangreiche Code-Migrationen unterstützt hat. Laut Google stieg die Zahl agentisch eingereichter Codeänderungen in einer internen Antigravity-Auswertung um rund 35 %, während nachträgliche Rollbacks um etwa 30 % zurückgingen. Das sind interessante Praxissignale – aber natürlich Ergebnisse aus Googles eigener Umgebung und keine neutrale Vergleichsstudie zwischen drei Anbietern.
Damit bekommt der Wettbewerb eine neue Qualität. Die eigentliche Frage lautet nicht mehr, ob Gemini mit Codex konkurrieren kann, sondern wie zuverlässig die komplette Arbeitsumgebung im eigenen Projekt funktioniert.
Komplette Webseiten? Das funktioniert inzwischen erstaunlich gut
Gerade für die Entwicklung von Webseiten ist dieser Fortschritt besonders spannend. Vor einigen Jahren war KI beim Programmieren häufig vor allem ein Werkzeug, das kleinere Codeblöcke oder ein paar CSS-Regeln vorgeschlagen hat. Heute lassen sich damit bereits umfangreiche Seiten, Dashboards, Verwaltungsoberflächen und Webanwendungen entwickeln.
Ein leistungsstarkes Modell wie Gemini 4 Argon kann hier sehr hilfreich sein – ebenso wie ChatGPT mit GPT-6 beziehungsweise einer entsprechend hohen Denkstufe. Entscheidend ist, wie genau die Anforderungen beschrieben werden und ob das Ergebnis anschließend überprüft wird.
Wer etwa eine komplette Webseite mit responsivem Design, Benutzerverwaltung, Datenbank, Suchfunktion, Filtern, Formularen und administrativem Bereich plant, sollte nicht einfach schreiben: „Erstelle eine professionelle Webseite.“
Viel besser ist es, die einzelnen Funktionen, die gewünschte Struktur, Designvorstellungen und technische Rahmenbedingungen sauber festzulegen. Dann kann eine KI das Projekt schrittweise entwickeln. Für eine größere produktive Seite bleiben Tests, Sicherheit, Performance und Wartbarkeit aber weiterhin wichtig.
Damit gewinnen Codex, Claude Code und inzwischen auch Antigravity erneut an Bedeutung. Wer die gesamte Projektstruktur einbindet, kann Fehler systematisch suchen lassen, bestehende Dateien ändern und automatisierte Tests durchführen lassen. Reiner Chat und agentische Entwicklung ergänzen sich also eher, als dass das eine das andere grundsätzlich ersetzt.
Bei Spielen wird es komplizierter – insbesondere bei großen Projekten
Eine Webseite zu erstellen ist schon nicht immer einfach. Ein großes Spiel zu entwickeln ist in vielen Bereichen noch einmal eine andere Herausforderung.
Ein Beispiel ist ein Spiel mit einer großen 3D-Welt, Inventarsystem, Crafting, Gegner-KI, Speicherständen, Kollisionen, Beleuchtung und dynamischer Weltgenerierung. Dann hängen zahlreiche Systeme zusammen. Ein vermeintlich kleiner Eingriff in die Spielerbewegung kann plötzlich die Kollisionen beeinflussen. Eine Änderung an der Weltgenerierung wirkt sich möglicherweise auf Ladezeiten, Speicherstände oder die Performance aus.
Solche Zusammenhänge kann eine KI zwar analysieren. Entscheidend ist aber, ob sie den tatsächlichen Projektstand kennt und ihre Änderungen im laufenden Entwicklungsprozess überprüfen kann.
Für größere Spiele mit Godot, Unity oder Unreal Engine empfiehlt Webstratege.de daher weiterhin den Einsatz eines echten Coding-Agenten. Codex und Claude Code haben in solchen Arbeitsabläufen bereits ihre Stärken. Eine gesunde Mischung aus beiden kann sinnvoll sein: Ein Werkzeug setzt eine Änderung um, das andere überprüft Architektur, Logik oder mögliche Nebenwirkungen.
Gemini 4 Argon gehört mit Antigravity inzwischen ebenfalls zu den ernsthaften Optionen. Ein umfangreiches Projekt allein wegen einer besonders schönen Benchmark-Grafik sofort auf ein anderes Werkzeug umzustellen, wäre allerdings wenig sinnvoll. Entscheidend sind reproduzierbare Ergebnisse im eigenen Code, stabile Builds und möglichst wenige neue Fehler.
Das gilt genauso für die klassischen Grundlagen: Clean Code, sinnvolle Tests, Versionsverwaltung, klare Schnittstellen und nachvollziehbare Änderungen bleiben wichtig. Auch die stärkste KI nimmt einem diese Arbeit nicht vollständig ab.
Testversionen statt Risiko für die Stable-Version – und alte Dateien rechtzeitig aufräumen
Besonders bei größeren Projekten sollte ein Coding-Agent nicht unkontrolliert an der letzten stabilen Version arbeiten. Sinnvoller sind getrennte Teststände, eigene Arbeitskopien oder Versionsverwaltungs-Branches. So können neue Funktionen, Fehlerbehebungen und Performance-Optimierungen erst geprüft werden, bevor sie in eine stabile Version übernommen werden.
Dabei sollte Codex die fertige Testversion ausdrücklich zur Durchsicht bereitstellen, statt sie eigenmächtig als neue Stable-Version festzulegen. Erst nach dem Test und einer Freigabe sollten die Änderungen übernommen werden. Bestehende Speicherstände, persönliche Daten, Sicherheitskopien und funktionierende Ausgangsversionen müssen geschützt bleiben.
Ein oft unterschätztes Problem ist der Speicherplatz. Bei wiederholten Testläufen, Kopien ganzer Projektordner, Build-Dateien, Logs und temporären Arbeitsverzeichnissen können sich über Wochen erhebliche Datenmengen ansammeln. In extremen Fällen kann ein eigentlich nur etwa 200 MB großes Projekt zusammen mit seinen alten Test- und Arbeitsständen auf 180 GB anwachsen. Das ist kein Normalwert, zeigt aber, wie schnell viele vergessene Zwischenstände eine SSD belasten können.
Deshalb gehört zu einem sauberen Entwicklungsauftrag auch eine Aufräumregel: Alte, eindeutig entbehrliche Testdateien erfassen und nach Freigabe entfernen. Die aktuelle Testversion, die geschützte Stable-Version, benötigte Backups und Nutzerdaten sind davon ausgenommen. Ideal ist eine kurze Übersicht, welche Ordner wie viel Platz belegen und was gefahrlos gelöscht werden kann. Auch hier gilt: Nicht blind löschen lassen, nur weil ein Verzeichnis groß aussieht.
Warum viele Entwickler erst einmal bei Codex oder Claude bleiben dürften
Claude Code ist bei Entwicklern sichtbar beliebt, Codex ebenfalls. Welches Werkzeug insgesamt etwas populärer ist, lässt sich ohne aktuelle und vergleichbare Nutzungszahlen allerdings kaum seriös sagen. Aussagen wie „Claude ist fünf Prozent beliebter“ klingen zwar schön konkret, wären ohne belastbare Daten aber letztlich nur eine Schätzung.
Und selbst wenn Gemini auf bestimmten Bestenlisten gewinnt, wechseln Entwickler nicht automatisch ihr Werkzeug.
Wer täglich mit einer bestimmten Umgebung arbeitet, hat seine Abläufe darauf abgestimmt. Repository-Zugriffe, Berechtigungen, Entwicklungsumgebung, Tests, verfügbare Kontingente und der Umgang mit bestehenden Projekten spielen eine gewaltige Rolle. Manche bevorzugen Claude Code, andere Codex. Nicht wenige nutzen auch beide Systeme, weil ein zweiter Blick bei schwierigen Aufgaben wertvoll sein kann.
Die Kombination beider Werkzeuge bleibt daher eine vernünftige Vorgehensweise. Gemini 4 Argon ist eine interessante zusätzliche Wahl – nicht zwingend der Grund, alles andere sofort aufzugeben.
Codex unterwegs nutzen: Remote-Zugriff vom Smartphone auf den heimischen PC
Eine inzwischen besonders praktische Funktion ist der Remote-Zugriff. Über die unterstützte ChatGPT- beziehungsweise Codex-Desktop-Umgebung kann ein Computer mit der ChatGPT-App auf dem Smartphone verbunden werden. Läuft Codex zu Hause auf dem PC, lässt sich unterwegs nachvollziehen, welche Dateien bearbeitet werden, welche Tests laufen und welche Rückfragen oder Freigaben anstehen. Auch neue Anweisungen sind möglich, ohne vor dem heimischen Bildschirm zu sitzen.
Voraussetzung ist, dass der Computer eingeschaltet, erreichbar und korrekt mit dem mobilen Gerät gekoppelt ist. Je nach App-Version wird die entsprechende Ansicht als „Remote“ oder innerhalb von Codex angezeigt. Die Projektdateien und lokalen Werkzeuge verbleiben auf dem verbundenen Rechner. Die Einrichtung und die jeweiligen Voraussetzungen erklärt OpenAI in der Dokumentation zu Remote-Verbindungen.
Ganz fehlerfrei wirkt diese Bedienung allerdings nicht in jeder Situation. Aus der praktischen Nutzung gibt es die Beobachtung, dass auf dem Smartphone eine über „Steuern“ gesendete Korrektur gelegentlich nicht erkennbar sofort in den laufenden Codex-Prozess einfließt. Stattdessen wird sie anscheinend erst berücksichtigt, wenn der aktuelle Arbeitsabschnitt abgeschlossen ist. Ob das am jeweiligen App-Zustand, der Verbindung oder an einem Fehler bei der Verarbeitung liegt, lässt sich daraus allein nicht sicher ableiten. Die Funktion sollte deshalb gerade bei wichtigen Zwischenkorrekturen kontrolliert werden.
Ein weiterer nachvollziehbarer Wunsch aus der Nutzerschaft ist eine möglichst einfache Pause-und-Fortsetzen-Funktion. Nach einer Unterbrechung sollte Codex im Idealfall selbstständig an der zuletzt erreichten Stelle weiterarbeiten können. In der Praxis ist es weiterhin sinnvoll, eine kurze Fortsetzungsanweisung zu geben, etwa mit dem Hinweis, am letzten geprüften Stand weiterzumachen und bereits erledigte Arbeit nicht zu wiederholen. Je nach Zustand der Sitzung muss der Agent die geänderten Dateien und offenen Arbeitsschritte zunächst erneut einordnen. Eine solche kurze Bestandsaufnahme ist sinnvoll – eine vollständige Wiederholung aller bisherigen Audits dagegen meist nicht.
Die Kosten: ChatGPT Pro, Codex-Kontingente und Geminis API-Preise
Ein Punkt wird bei solchen Vergleichen oft unterschätzt: Leistungsfähigkeit ist schön, aber bei intensiver Nutzung entscheiden auch die Kosten.
OpenAI bietet unter anderem eine ChatGPT-Pro-Stufe ab 100 US-Dollar pro Monat an. Daneben gibt es weitere Pro-Stufen mit höheren Nutzungskontingenten. Je nach Land, Währung, Abrechnung und Steuern kann der tatsächlich angezeigte Europreis abweichen. Für jemanden, der sehr intensiv programmiert und Codex täglich nutzt, können die erweiterten Kontingente durchaus interessant sein. Kostenlos oder unbegrenzt im wörtlichen Sinn ist die Rechenleistung deshalb trotzdem nicht.
Die jeweils aktuellen Konditionen lassen sich auf der Codex-Preisseite und bei den ChatGPT-Tarifen überprüfen.
Google nennt für die Gemini-4-Argon-API zunächst einen Einführungspreis von 2 US-Dollar pro Million Input-Tokens und 10 US-Dollar pro Million Output-Tokens. Laut Google soll nach Ablauf der Einführungsphase am 30. November 2026 der reguläre Preis von 4 beziehungsweise 20 US-Dollar gelten. Das sind API-Verbrauchspreise und keine pauschalen Monatsabos. Auch bei Google Antigravity und der Gemini-App gelten die jeweiligen Zugangs- und Nutzungsbedingungen.
Man sollte deshalb nicht einfach „100 Dollar ChatGPT gegen zwei Dollar Gemini“ rechnen. Das wäre ungefähr so sinnvoll, als würde man den Preis einer Softwarelizenz mit dem Stromverbrauch eines einzelnen Rechenvorgangs vergleichen. Die Kostenmodelle sind unterschiedlich.
Codex-Kontingente: Nicht jede Aufgabe braucht endlose Audits und Testschleifen
Selbst bei einem kostenpflichtigen Pro-Tarif im Bereich von rund 100 Euro beziehungsweise 100 US-Dollar pro Monat können größere Entwicklungsprojekte spürbar an die verfügbaren Kontingente gehen. Das liegt nicht nur am eigentlichen Programmieren. Auch wiederholte Analysen, sehr große Projektkontexte, zusätzliche Korrekturrunden und vom Agenten gestartete Prüfungen können Modellarbeit verursachen. Ein langer Codex-Lauf ist deshalb nicht automatisch produktiver als ein kurzer, gezielter Eingriff.
Die Lösung besteht allerdings nicht darin, sämtliche Tests abzuschalten. Bei Änderungen an Datenbanken, Sicherheit, Speicherständen oder miteinander verbundenen Spielsystemen sind Prüfungen unverzichtbar. Entscheidend ist eine klare Begrenzung auf die tatsächlich betroffenen Bereiche: erst das Problem eingrenzen, dann die notwendige Änderung umsetzen, anschließend einen passenden Test durchführen und das Ergebnis nachvollziehbar dokumentieren. Ein vollständiges Projektaudit sollte nur bei einem konkreten Anlass oder nach ausdrücklicher Freigabe folgen.
Eine mögliche Arbeitsanweisung an Codex lautet beispielsweise: „Untersuche zuerst nur die betroffenen Dateien, setze die Änderung möglichst isoliert um und führe anschließend die dafür notwendigen Tests durch. Vermeide wiederholte Voll-Audits ohne neuen Fehlerhinweis. Lege eine Testversion zur Freigabe vor, verändere die Stable-Version nicht und melde, wenn zusätzliche große Prüfungen erforderlich wären.“
Wird der Arbeitsumfang zu Beginn festgelegt, lassen sich unnötige Schleifen oft vermeiden. Dasselbe gilt für neue Ideen während eines laufenden Jobs: Eine rechtzeitige Korrektur über „Steuern“ kann verhindern, dass Codex zunächst einen unerwünschten Weg zu Ende verfolgt und später alles erneut prüfen muss. Wie schnell ein Kontingent tatsächlich verbraucht wird, hängt laut OpenAI-Hilfe zu Codex und den Nutzungslimits unter anderem vom Modell, der Komplexität, dem Kontext und den verwendeten Werkzeugen ab. Automatische Sicherheitsprüfungen sind dabei nicht mit ausdrücklich beauftragten umfangreichen Code-Audits gleichzusetzen.
Gemini 4 Argon: Wo liegen die Stärken und Schwächen?
Auf Grundlage der bisherigen Veröffentlichungen ergibt sich folgende Einordnung der drei Anbieter. Wichtig: Das ist eine qualitative Einschätzung auf Basis öffentlich verfügbarer Informationen, kein eigener Langzeittest.
| Werkzeug | Stärken | Was man beachten sollte |
|---|---|---|
| Gemini 4 Argon mit Antigravity | Starke Ergebnisse bei Wissensarbeit, langen Aufgaben und ausgewählten Coding-Tests; große Kontextkapazität; agentisches Arbeiten. | Nicht in jedem Coding-Test führend; relativ neue öffentliche Einführung; Limits und Abläufe vor Projektumstieg prüfen. |
| GPT-6 Astra mit Codex | Starke Softwareentwicklung, direkte Projektarbeit, Tests und strukturierte Codeänderungen; Spitzenwert bei FrontierSWE v2. | Nutzungskontingente hängen vom Tarif und der Aufgabe ab; gute Ergebnisse ersetzen keine Kontrolle. |
| Claude Opus 5.5 mit Claude Code | Leistungsstarker Coding-Agent, sehr gutes Terminal-bench-Ergebnis, geeignet für Änderungen und Prüfungen in Codeprojekten. | Nicht überall Benchmark-Sieger; Kosten, Kontext und Projektkonfiguration bleiben entscheidend. |
Fazit: Google hat aufgeholt – aber der Wettkampf ist noch lange nicht entschieden
Gemini 4 Argon ist nicht bloß eine weitere KI, die ein paar Prozent mehr in irgendeiner Tabelle erreicht. Google zeigt damit, dass es bei komplexer Wissensarbeit, Programmierung und Cybersicherheit ganz vorne mitspielen möchte. Besonders die Verbindung mit Antigravity macht das Modell für Entwickler interessant.
Gleichzeitig sollte man die veröffentlichten Zahlen nicht mit einem endgültigen Urteil verwechseln. GPT-6 Astra bleibt bei anspruchsvollen Softwareaufgaben extrem leistungsfähig, und Claude Opus 5.5 zeigt gerade bei agentischen Terminalaufgaben klare Stärken. Gemini gewinnt andere Tests, liegt aber eben nicht überall vorne.
Wer heute eine anspruchsvolle Webseite entwickeln möchte, hat mehr Möglichkeiten als je zuvor. Mit ChatGPT in einer hohen Denkstufe, Gemini 4 Argon oder Claude können bereits erstaunlich umfangreiche Entwürfe und Programme entstehen. Wer dagegen täglich an einem großen und dauerhaft wachsenden Software- oder Spieleprojekt arbeitet, sollte sich zusätzlich mit Codex, Claude Code und Antigravity beschäftigen.
Webstratege.de empfiehlt deshalb keinen vorschnellen Wechsel. Sinnvoller ist es, Gemini 4 Argon gezielt mit denselben Aufgaben zu testen, die bisher mit Codex oder Claude bearbeitet wurden – und dabei nicht nur den ersten brauchbaren Code zu vergleichen, sondern auch Korrekturen, Tests, Nebenwirkungen und den tatsächlichen Arbeitsaufwand.
Wer das macht, findet möglicherweise einen neuen Favoriten. Oder stellt fest, dass gerade die Kombination aus mehreren KI-Systemen die besten Ergebnisse liefert.
Dieser Gedanke wurde bereits im Webstratege.de-Artikel „Künstliche Intelligenz ist längst überall – aber sie ist nicht unfehlbar“ aufgegriffen: KI kann einen erheblichen Teil der Arbeit erleichtern. Die Verantwortung, das Ergebnis zu verstehen und zu prüfen, bleibt trotzdem beim Menschen.
Gerade im Entwicklungsalltag kommt noch etwas hinzu: Gute Prompts, rechtzeitige Kurskorrekturen, überprüfbare Teststände und ein kontrollierter Ressourcenverbrauch sind mindestens so wichtig wie ein Platz ganz oben in einer Benchmark-Tabelle. Ein Modell ist erst dann wirklich hilfreich, wenn am Ende ein besseres und stabiles Projekt entsteht.
Quellen und weiterführende Informationen
- Google: Erste Ankündigung von Gemini 4 Argon (Englisch, 30.09.2026)
- Google: Gemini 4 Argon ist verfügbar (Deutsch, 13.10.2026)
- Google DeepMind: Modellkarte mit vollständigen Benchmark-Werten (Englisch)
- Google DeepMind: Methodik der Benchmark-Auswertung (Englisch)
- Google Antigravity: Argon in der Programmierumgebung (Englisch)
- Golem.de: Bericht über Gemini 4 Argon (Deutsch)
- The Decoder: Unabhängige Einordnung von Benchmarks (Englisch, 16.10.2026)
- OpenAI: Codex-Nutzung und Tarife (Deutsch)
- Anthropic: Claude Code – Dokumentation (Englisch)
- OpenAI Developers: Codex auf dem Smartphone – Steuern und Warteschlange (Englisch)
- OpenAI: Remote-Verbindungen zwischen Desktop und Smartphone (Englisch)
- OpenAI: Codex mit einem ChatGPT-Tarif verwenden und Nutzungslimits verstehen (Deutsch)
Stand: 24. Oktober 2026. Modellversionen, Benchmarks, Verfügbarkeiten und Preise ändern sich gefühlt täglich.
